인덱스 동작 리뷰
이미 존재하는 인덱스 조회
SELECT index_name, table_name
FROM USER_INDEXES
WHERE table_name = 'table_name';
인덱스 사용이 불가능한 쿼리
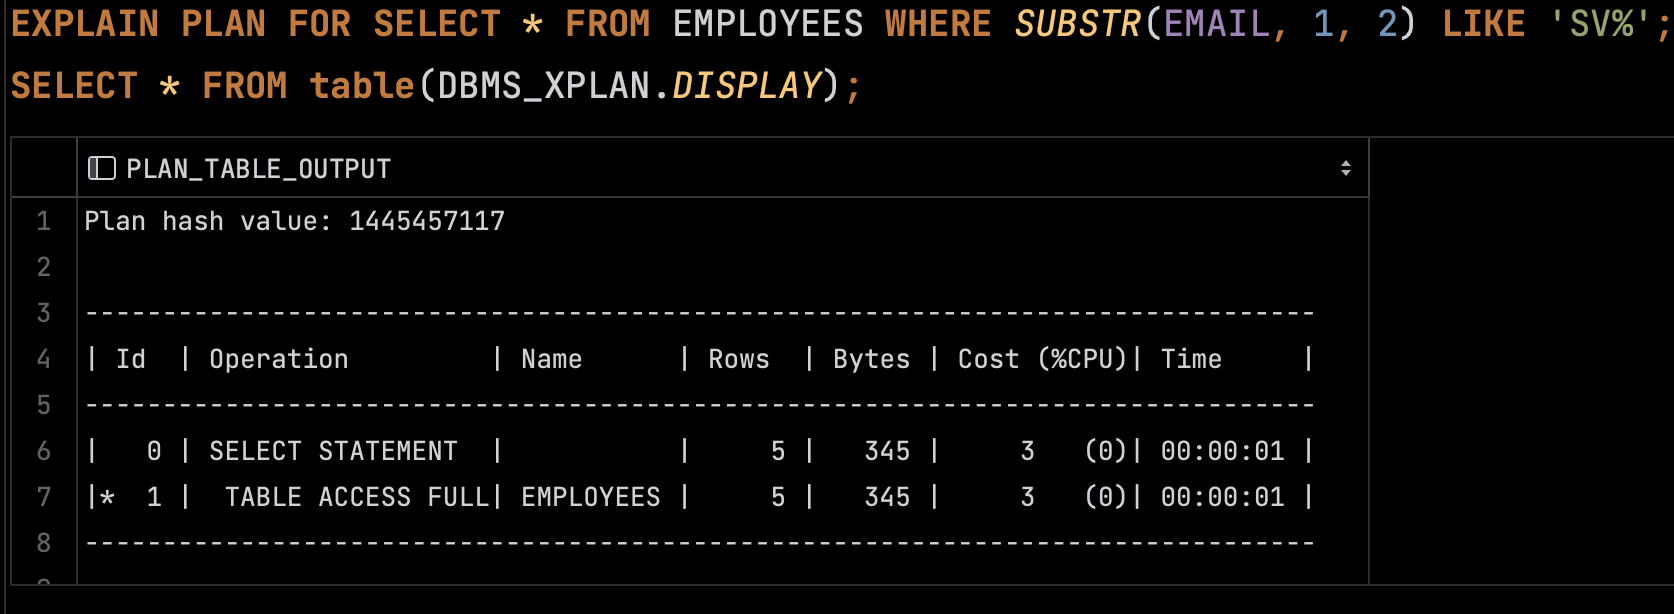
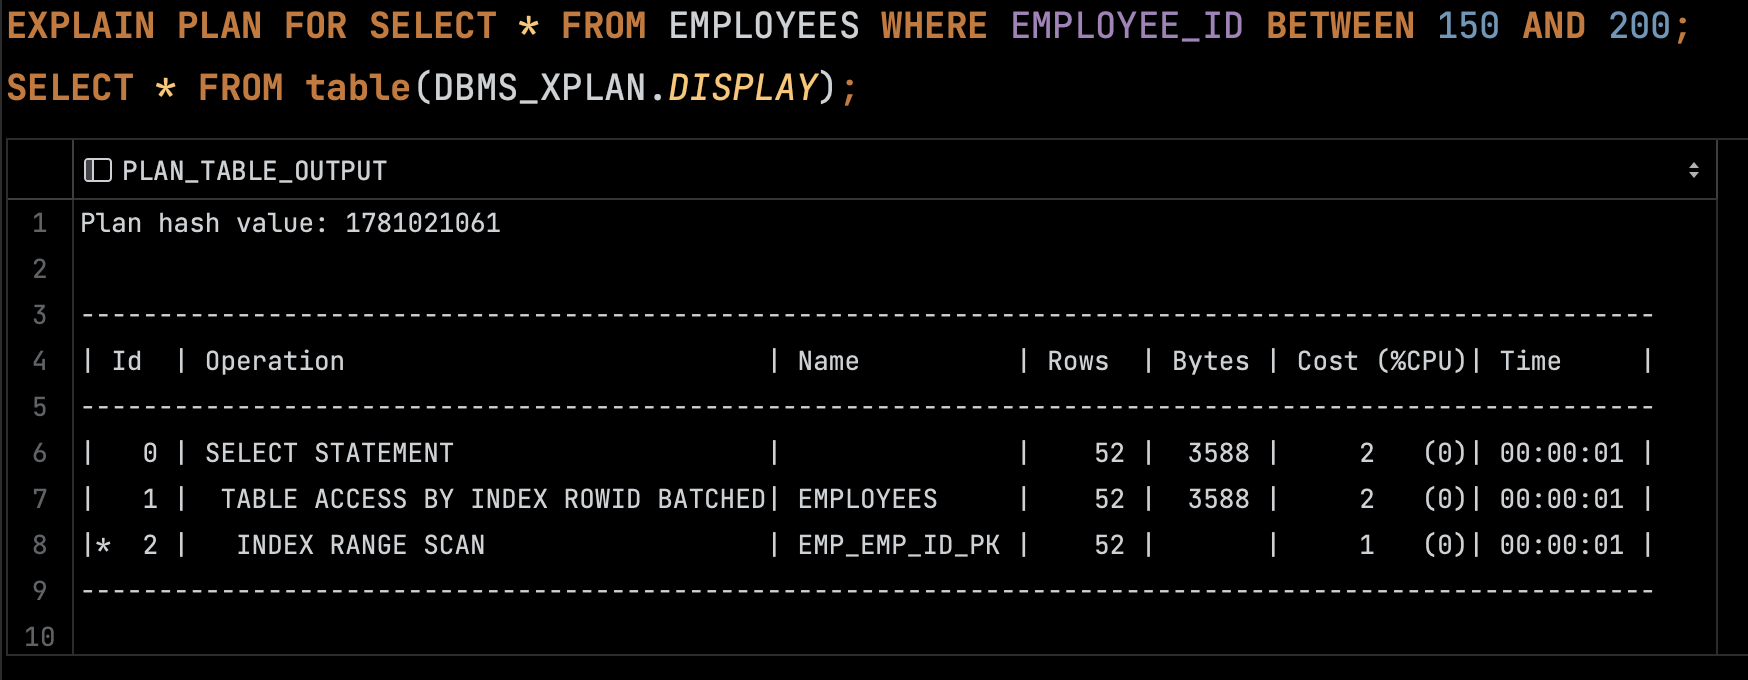
SELECT * FROM EMPLOYEES WHERE SUBSTR(EMAIL, 1, 2) LIKE 'SV%';- 컬럼으로 비교한 것은 인덱스 스캔을 하지만
SUBSTR같은 컬럼을 조건절에서 가공하는 경우
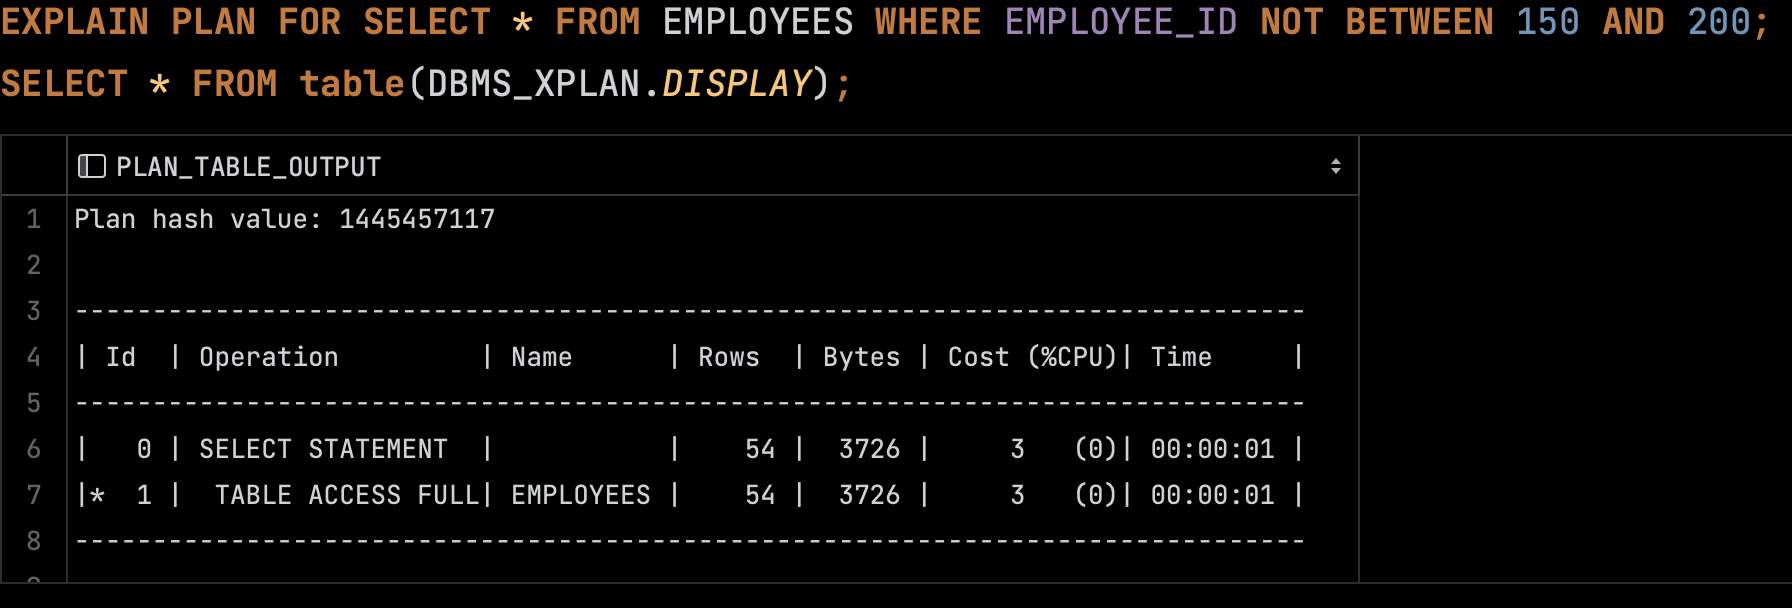
SELECT * FROM EMPLOYEES WHERE EMPLOYEE_ID NOT BETWEEN 150 AND 200;- 부정형 비교를 사용하는 경우 인덱스 사용 불가
인덱스 쿼리 개선 사례
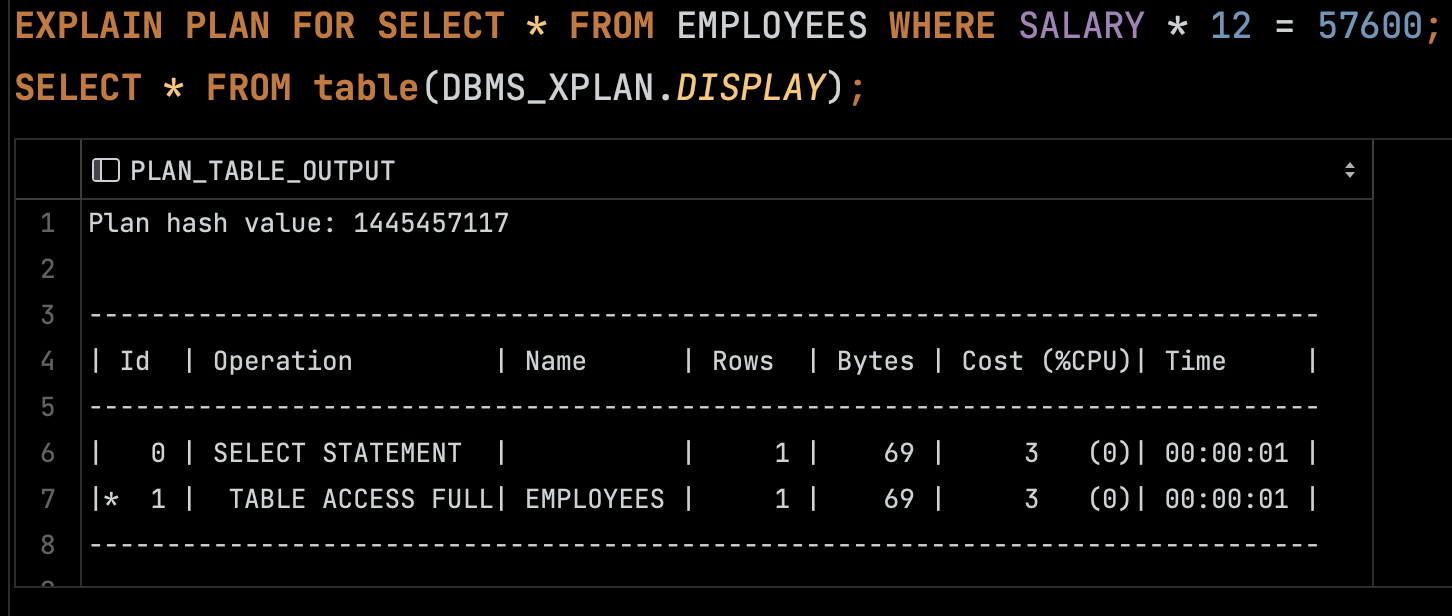
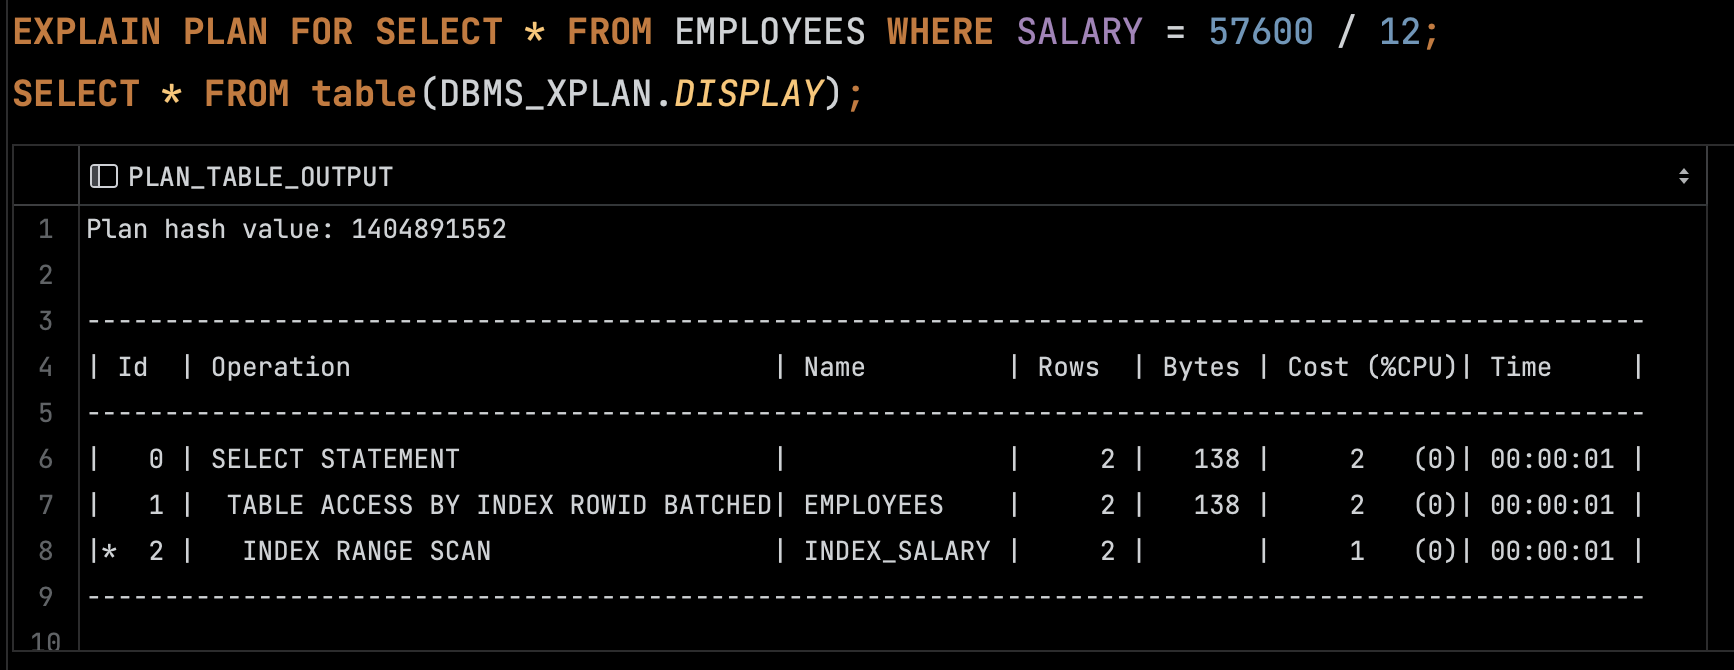
- 인덱스 컬럼을 가급적 가공하지 않는 방향으로 SQL 조건절을 개선
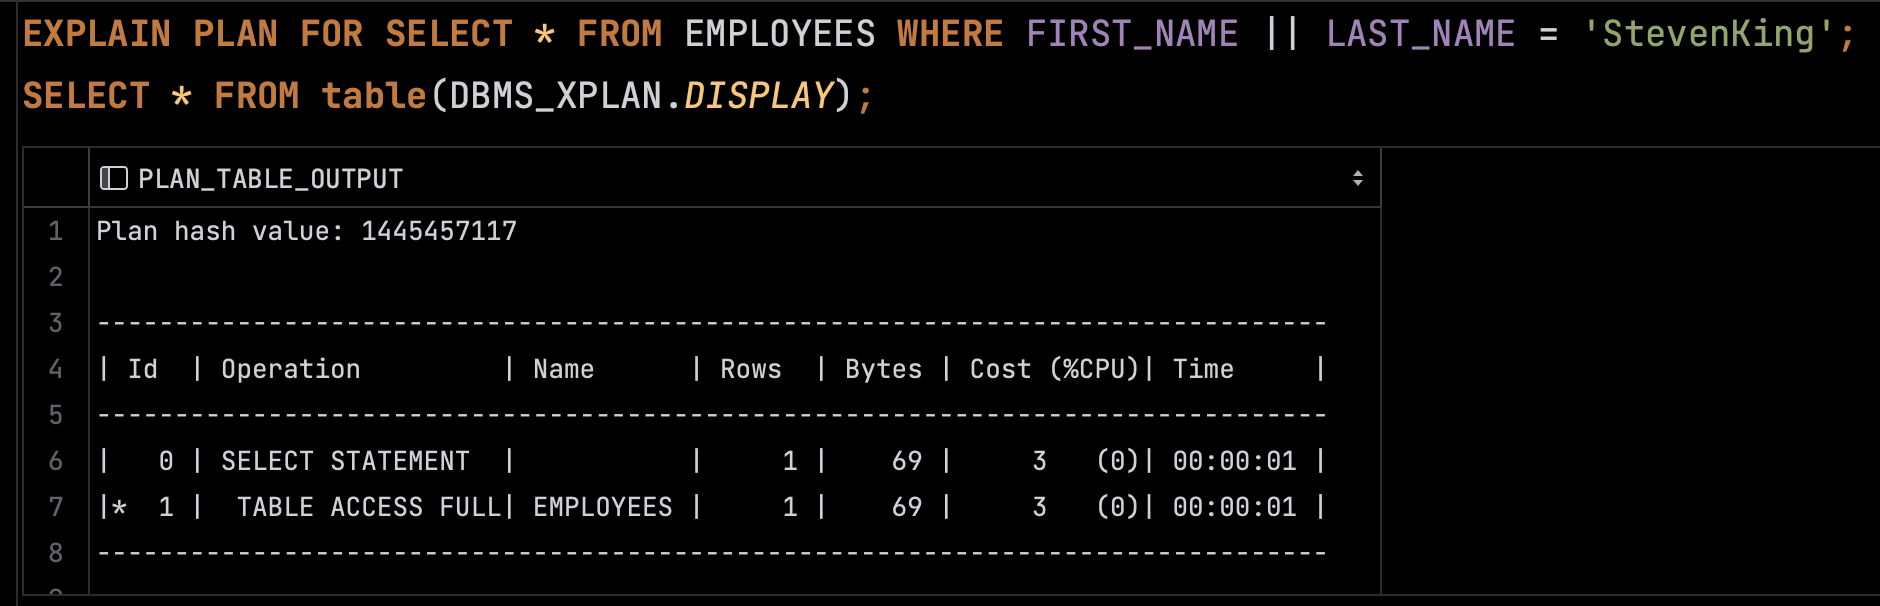
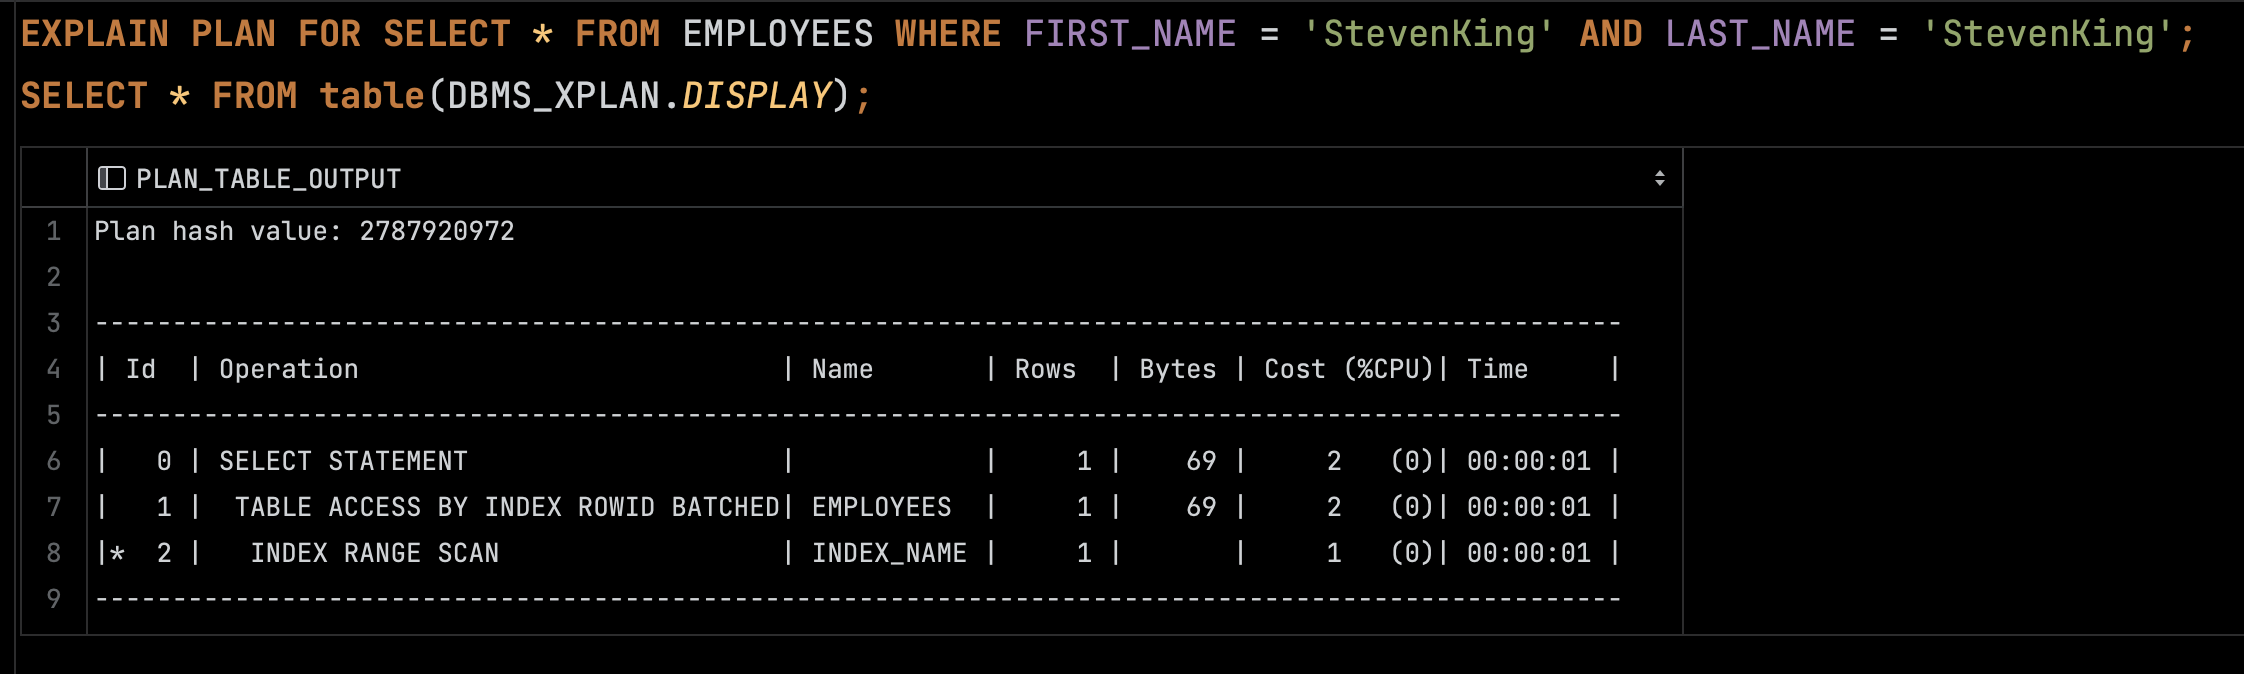
- 컬럼의 결합으로 쿼리를 구성 -> 컬럼 각각을 비교
인덱스 컬럼 선정 기준
인덱스 컬럼 선정 기준
분포도가 좋은 컬럼인가?
- 컬럼 분포도: 전체 레코드에서 식별 가능한 수에 대한 백분율
-
ex) 고객 테이블에서 성별 컬럼은 식별 가능한 수가 2이며 분포도는 50%
-
ex) 고객 아이디 컬럼은 식별가능한 수가 N이며, 분포도는 1/N*100%
-
- 분포도가 좋은 (1% 미만?) 컬럼을 선정하는 것을 권장하지만, 분포도 만으로 판단하는 것은 위험함
-
ex) 생년월일 컬럼의 분포도는 매우 좋지만 (365일*100년), 실제 연도까지 사용하는 경우는 많지 않음
-
ex) 배송여부 컬럼(Y,N)은 식별 가능수가 2로 분포도가 좋지 않을 것으로 생각되지만, 실제 대부분은 값은 Y이고 최근 주문한 소수의 레코드가 N 값을 가짐
-
업데이트가 자주 발생하지 않는 컬럼인가?
- 인덱스 밸런싱: 인덱스 컬럼이 자주 업데이트 되면, 인덱스 밸런싱이 깨짐
- INSERT, DELETE, UPDATE시 인덱스도 함께 변경되므로 비용이 발생
-
ex) UPDATE 자주 발생하는 컬럼의 예: 수정일자, 종료일자, 승인일자, 상태코드, 결과코드, 배송여부, 진행상태코드 등
-
- 갱신이 자주 발생하는 컬럼은 인덱스 컬럼으로 서정 시 신중 해야 함
조건절에서 자주 사용되는 컬럼인가?
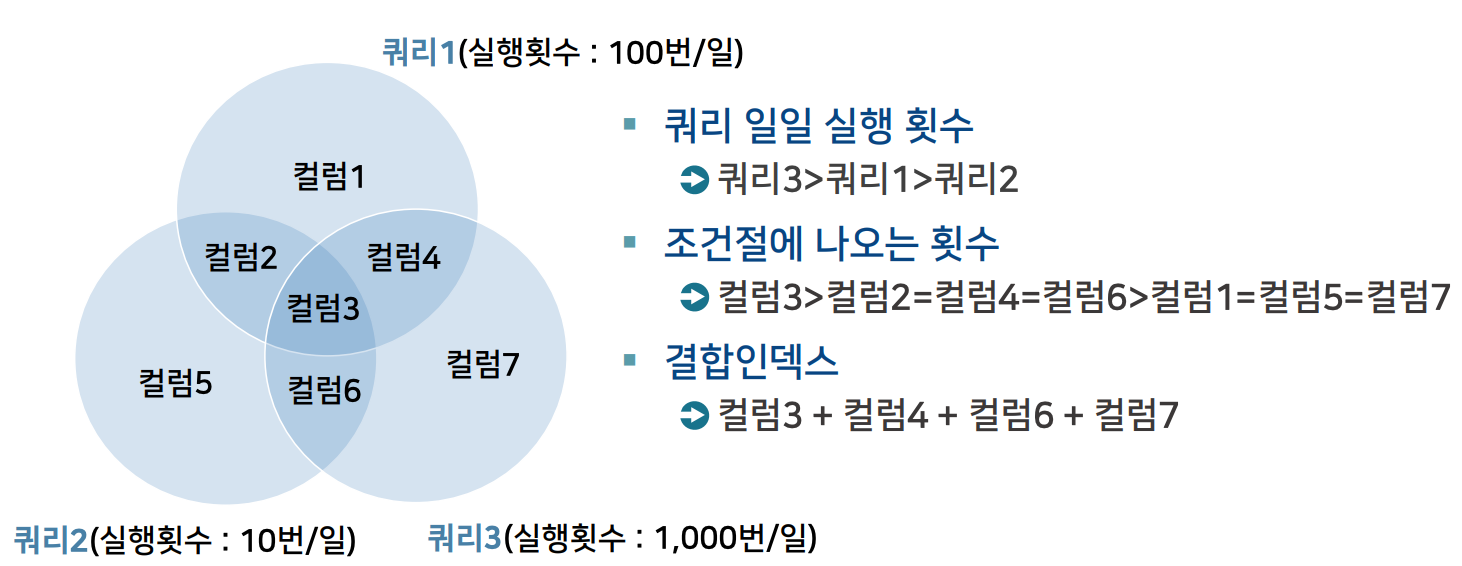
- 쿼리 실행 횟수
- 조건절에 사용되는 모든 컬럼에 인덱스를 생성하는 것은 성능 저하를 가져옴
- 필요한 만큼의 인덱스를 생성
- 쿼리 실행 빈도수가 상대적으로 높은 컬럼에 인덱스를 생성
조인의 연결고리에 사용되는 컬럼인가?
- Nested Loop Join: 온라인 쿼리의 90% 이상을 차지하며 조인절에 인덱스가 반드시 필요
- Sort Merge Join: 조인절에 인덱스가 반드시 있어야 하는 것은 아님
- Hash Joi: 조인절에 인덱스가 반드시 있어야 하는 것은 아님