인덱스(Index)
인덱스 정의
- 데이터에 대한 논리적 포인터의 집합으로 책의 찾아보기와 같은 역할
- 테이블 로우의 특정값(ROWID)과 특정 컬럼의 정렬된 값을 결합하여 구조화
- 질의문의 빠른 수행과 컬럼값의 유일성을 보장하기 위해서 사용
인덱스 예
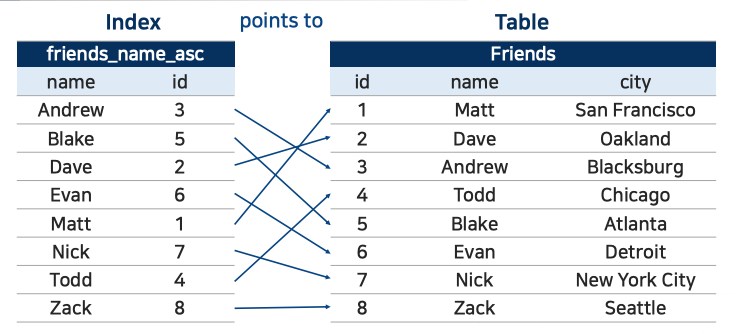
인덱스의 필요성
- 테이블 로우는 데이터 파일의 블록의 빈 공간에 저장됨
- 데이터베이스는 각 테이블의 모든 페이지에 있는 데이터를 읽어서 원하는 로우를 찾아야 함
- 작은 크기의 테이블은 없어도 무관
- 대부분의 경우 데이터 접근 속도가 빨라짐
- 장점:
- 빠르게 데이터를 찾아낼 수 있음
- 유일 인덱스로 만들면 UNIQUE 제약조건도 강화할 수 있음
- 단점:
- 인덱스 자체가 추가적인 공간을 차지하고, 인덱스를 유지 관리 하는데 추가적인 시간이 소비됨
- 인덱스를 이용해서 데이터를 검색할 때는 시간이 줄어들지만, 데이터를 추가하고 수정할 때는 인덱스 떄문에 시간이 더 걸림
인덱스를 생성해야 하는 경우
- SQL문에서 컬럼이 WHERE 절 또는 JOIN 조건에서 자주 사용될 때
- 컬럼에 광범위한 값이 포함될때 (범위 검색)
- 컬럼에 많은 수의 NULL 값을 포함할 때
- 대형 테이블이고 대부분의 질의가 10~15% 이하로 로우를 읽어 들일 것으로 예상할 때
인덱스를 생성하지 않아야 하는 경우
- 테이블에 자료의 양이 적을 때
- 컬럼이 WHERE 조건으로 자주 사용되지 않을 때
- 질의 대부분이 10~15% 이상 데이터를 읽어올 것으로 예상될 때
- 테이블에 빈번하게 삽입, 수장, 삭제가 일어날 때
인덱스 종류
논리적 분류
- 단일 컬럼 인덱스: 하나의 컬럼 으로 인덱스를 구성
- 복합 인덱스: 두개 이상의 컬럼으로 인덱스를 구성 (oracle 21-c 는 32개 까지 가능)
- 유일 인덱스: 중복된 값이 존재하지 않는 인덱스
- 비유일 인덱스: 중복된 값이 허용되는 인덱스
- 함수 기반 인덱스: 함수나 표현식으로 컬럼 값을 계산 하여 인덱스에 저장
물리적 분류
- 역방향 인덱스:
- B-Tree 인덱스에서 컬럼의 값을 뒤집어서 배열
- 연속된 데이터의 경우 이전의 데이터를 지우면 한쪽으로 치우치는 현상이 발생하고 균형이 깨지는 것을 방지
- 비트맵 인덱스: 인덱스에 저장된 컬럼의 값을 바이너리로 저장
- 비트맵-조인 인덱스:
- 기본 구조는 비트맵 인덱스와 동일
- 두개 이상의 테이블 조인 결과에 대해서 정의되어 생성된 인덱스
- 유일 인덱스: 중복된 값이 존재하지 않는 인덱스
인덱스 구조와 작동원리
B-Tree(Balanced Tree, 균형트리)
- 균형트리는 양쪽 노드의 높이 차가 1 이하인 트리로 원하는 값을 찾고자 할 때 일정한 성능을 보장
- 대부분의 DBMS는 B-Tree 구조를 사용하여 인덱스로 표현
- 데이터의 검색(SELECT) 시에 뛰어난 성능을 보일 수 있음
- 데이터 변경(INSERT, UPDATE, DELETE) 시에 성능이 나빠짐
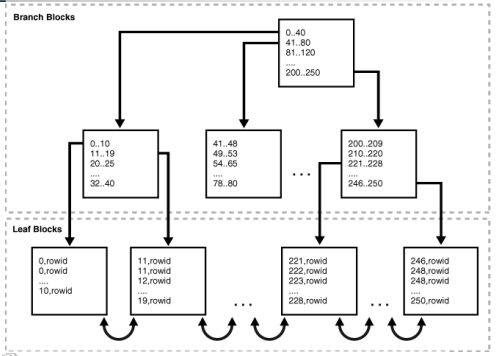
인덱스(B-Tree) 구성
- 브랜치(branch) 블록과 리프(leaf) 블록으로 구성
- 루트에서 리프 블록까지의 거리를 **인덱스 깊이(Height)**라고 하며, 인덱스를 반복적으로 탐색할 때 성능에 영향을 미침
- 루트와 브랜치 블록은 각 하위 노드들의 데이터 값 범위를 나타내는 키 값과, 그 키 값에 해당 하는 블록을 찾는 데 필요한 주소 정보를 가짐
- 리프 블록은 인덱스 키 값과, 그 키 값에 해당하는 테이블 레코드를 찾아가는 데 필요한 **주소 정보(ROWID)**를 가짐
- 리프 블록은 항상 인덱스 키(Key) 값 순으로 정렬돼 있기 때문에 “범위 스캔(Range Scan, 검색조건에 해당 하는 범위만 읽다가 멈추는 것을 말함)“이 가능하다.
- 정방향(Ascending)과 역방향(Descending) 스캔이 둘 다 가능하도록 양방향 연결 리스트(Double linked list) 구조로 연결됨
- DBMS 종류에 따라 인덱스 구성에 null 인 레코드를 포함하거나 포함하지 않는다.
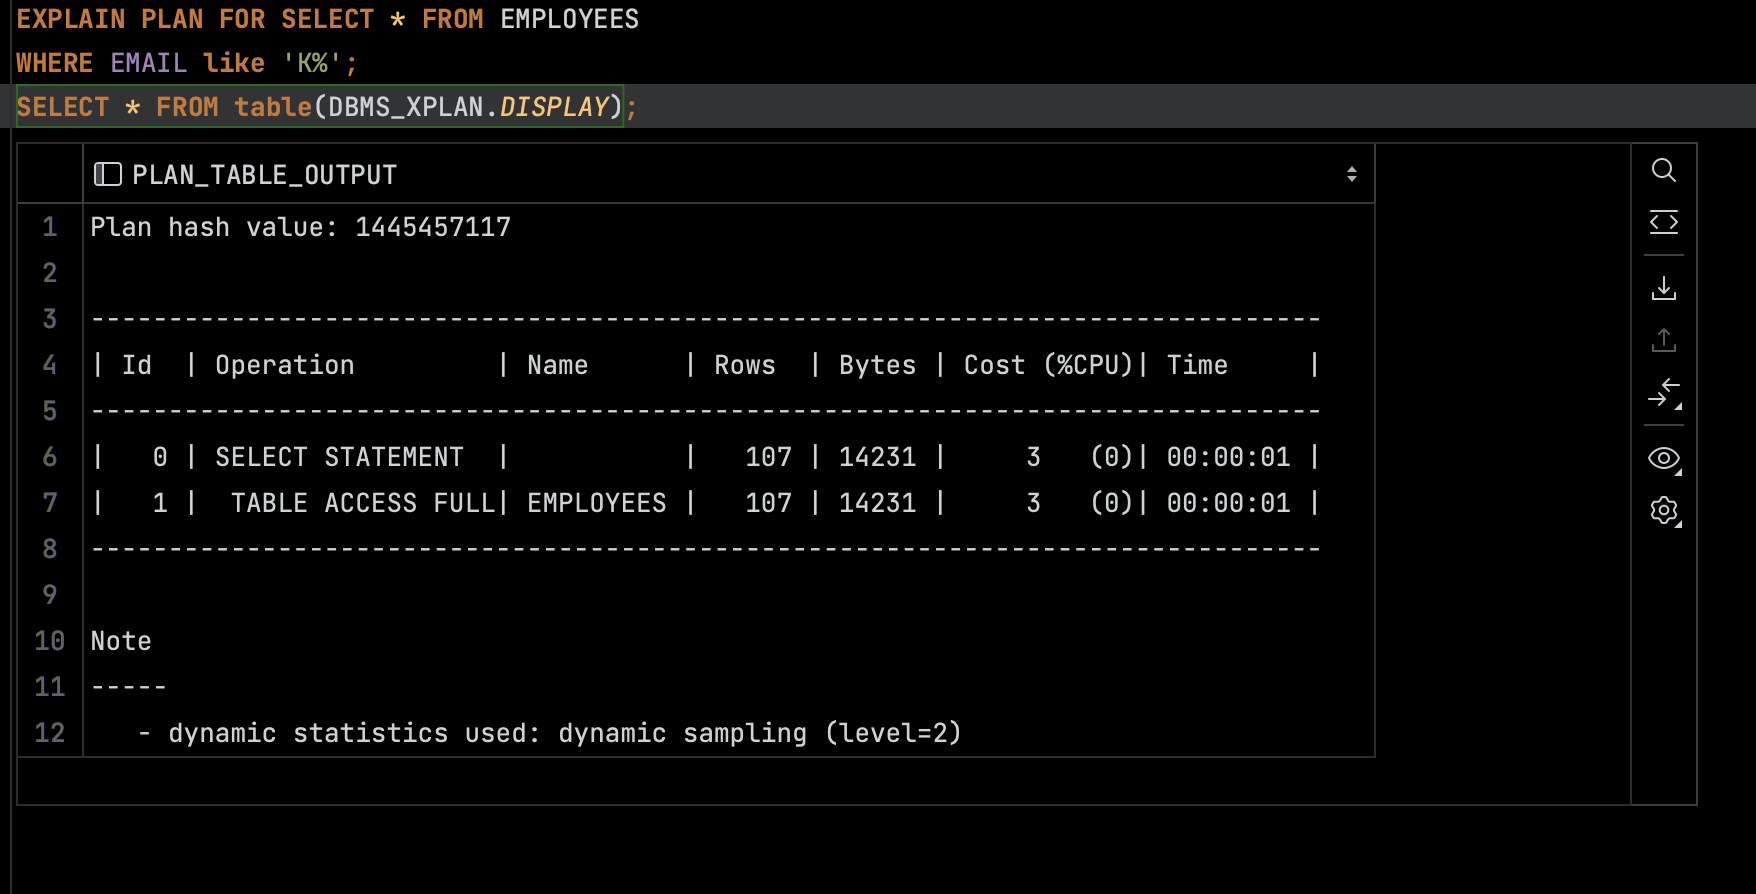
인덱스 Range 스캔(Index Range Scan)
- 인덱스 루트 블록에서 리프 블록까지 수직적으로 탐색한 후에 리프 블록을 필요한 범위(Range)만 스캔하는 방식
- B-Tree 인덱스의 가장 일반적이고 정상적인 형태의 액세스 방식
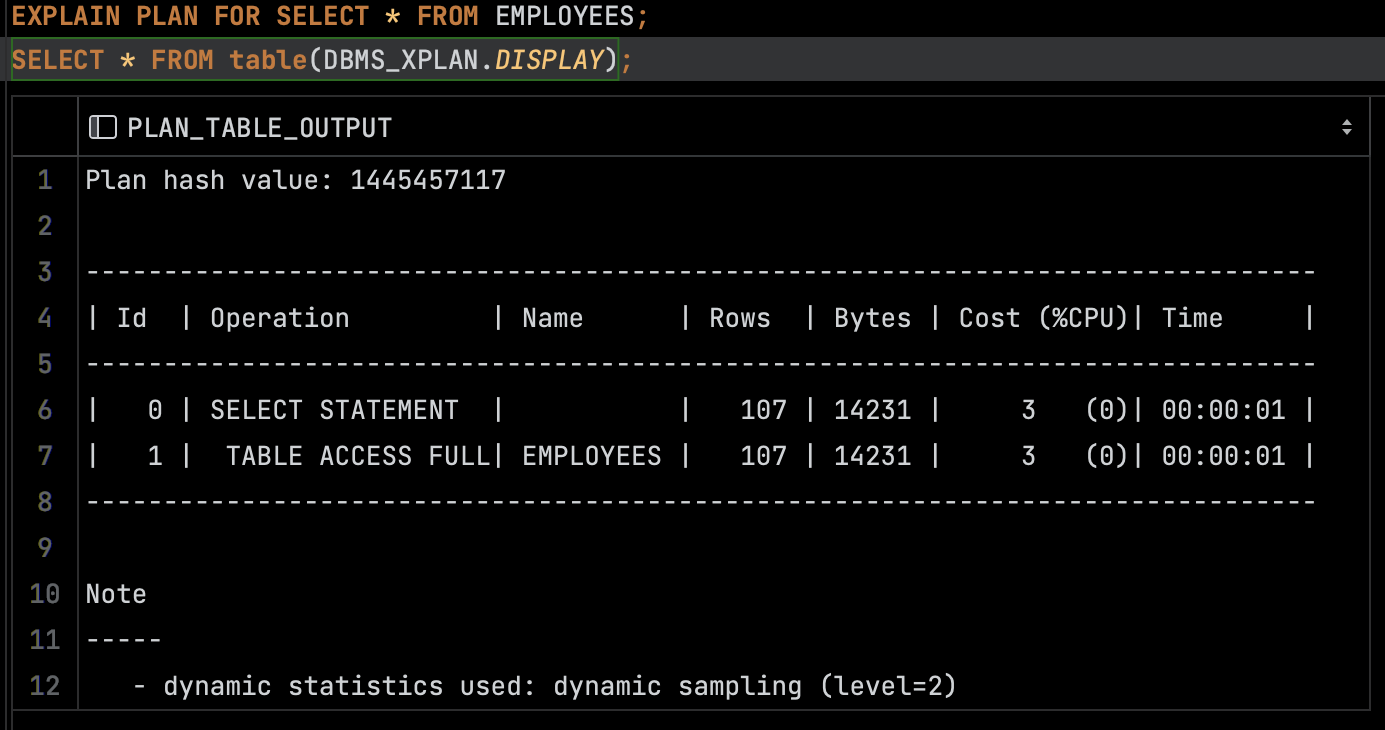
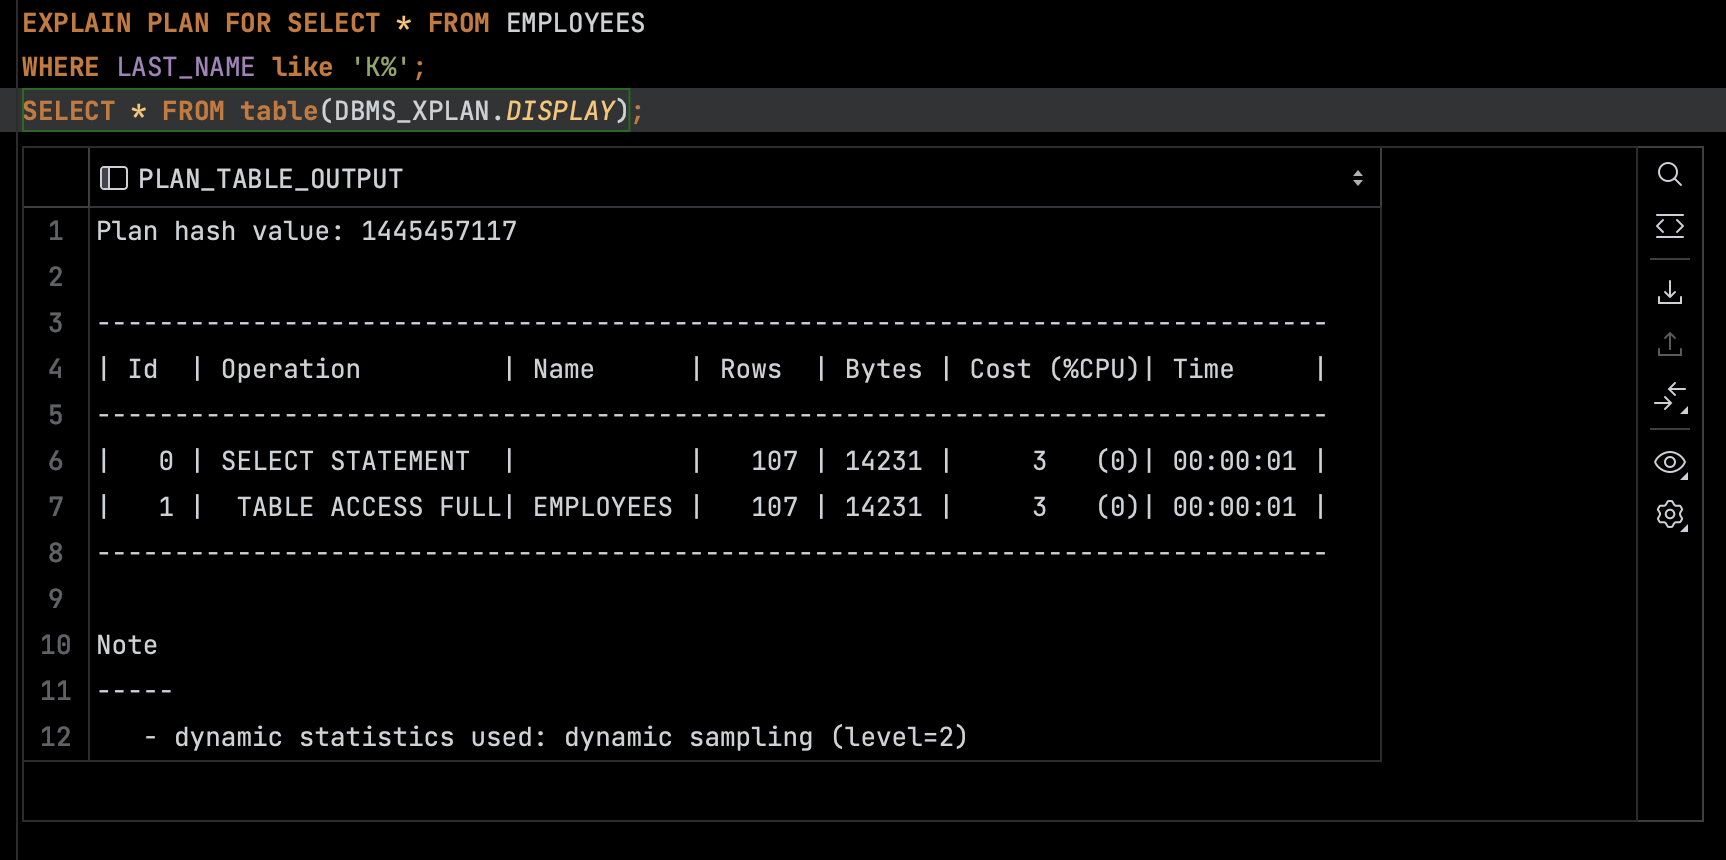
인덱스 Range 스캔 (Oracle 21-C)
- TODO: 값이 적어서 Full Scan만 함 특정 Scan 전략을 채택하게 강제해서 테스트
인덱스 Unique 스캔(Index Unique Scan)
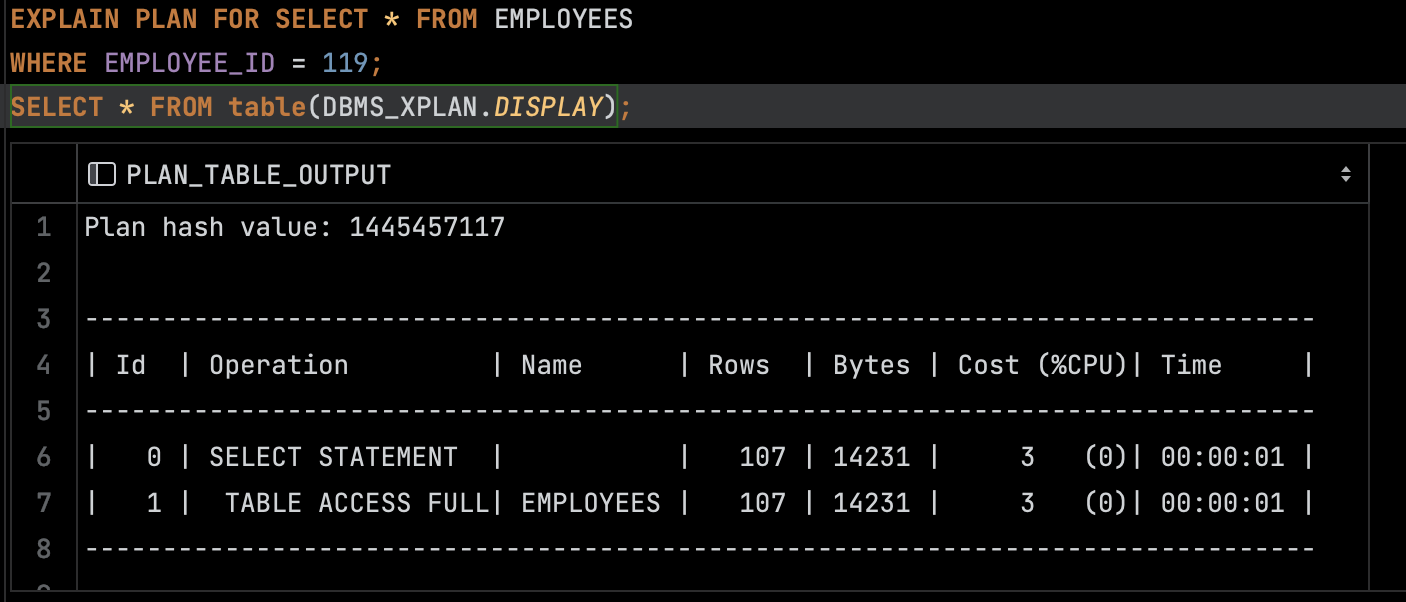
- 수직접 탐색만으로 데이터를 찾는 스캔방식으로서, Unique 인덱스를 ’=’ 조건으로 탐색하는 경우에 작동
- 일치하는 값을 찾은 경우 바로 멈춤
인덱스 Unique 스캔 (Oracle 21-C)
인덱스 Full 스캔(Index Full Scan)
- 수직적 탐색없이 인덱스 리프 블록을 처음부터 끝까지 수평적으로 탐색 하는 방식
- 대개는 데이터 검색을 위한 최적의 인덱스가 없을 때 차선으로 선택
- 인덱스 선두 컬럼이 조건절에 없으면 우선적으로 Table Full Scan 을 고려
- 대용량 테이블이라서 Table Full Scan이 부담이 큰 경우 인덱스를 활용
- 인덱스 만으로도 원하는 결과를 얻을 수 있는 경우 Index Full Scan을 고려
- ORDER BY 절의 컬럼으로 인덱스가 구성된 경우
- GROUP BY 절의 컬럼으로 인덱스가 구성된 경우
- 인덱스 스캔 단계에서 대부분의 로우를 필터링하고 일부에 대해서만 테이블 액세스하는 것이 효율적이라고 판단되면 Index Full Scan 방식을 선택
- etc:
- 인덱스 구조를 따라 스캔
- 결과집합 순서 보장
- Single Block I/O
- 병렬스캔 불가
- 인덱스에 포함되어 있지 않은 컬럼 조회 시에도 사용가능
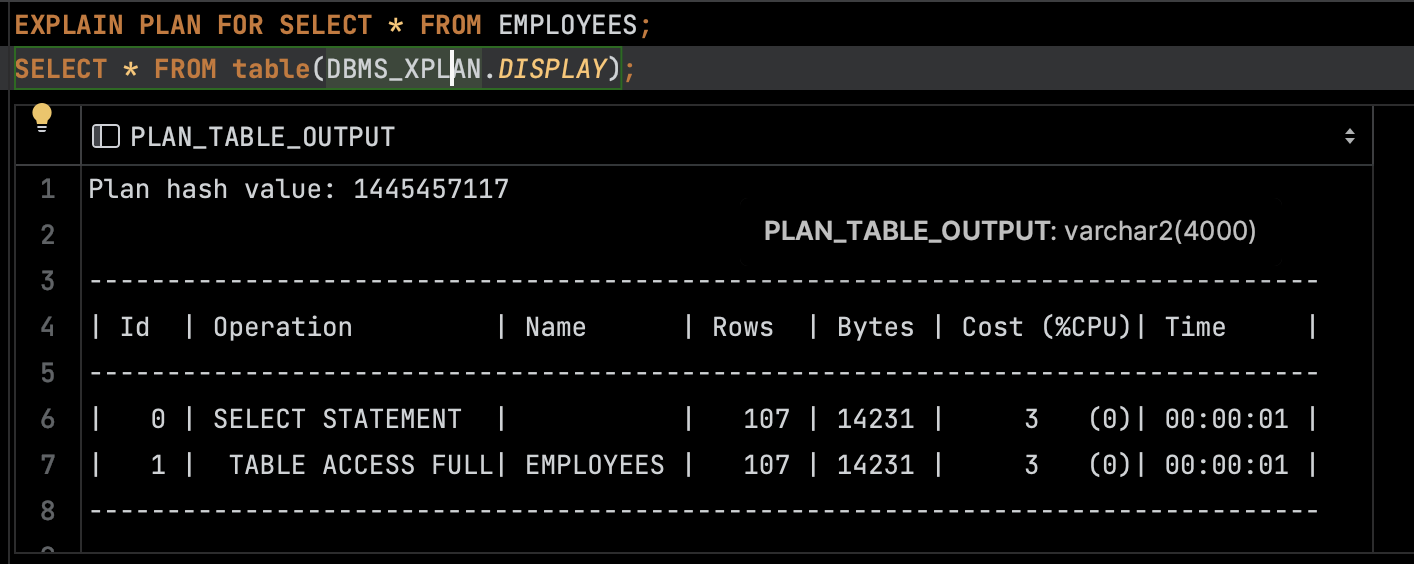
인덱스 Full 스캔 (Oracle 21-C)
인덱스 Skip 스캔(Index Skip Scan)
- 루트 또는 브랜치 블록에서 읽은 컬럼 값 정보를 이용해 조건에 부합하는 레코드를 포함할 ‘가능성이 있는’ 하위 블록(브랜치 또는 리프 블록)만 골라서 액세스하는 방식
- 조건절에 빠진 인덱스 선두 칼럼의 Distinct Value 개수가 적고 후행 칼럼의 Distinct Value 개수가 많을 때 유용
인덱스 Fast Full 스캔(Index Fast Full Scan)
- 인덱스 트리구조를 무시하고, 인덱스 세그먼트 전체를 멀티블록 읽기 방식으로 스캔
- 세그먼트(인덱스) 전체를 스캔
- 결과집합 순서 보장 안됨
- Multiblock I/O
- 병렬스캔 가능
- 인덱스에 포함된 컬럼으로만 조회할 때 사용 가능
인덱스 생성과 관리
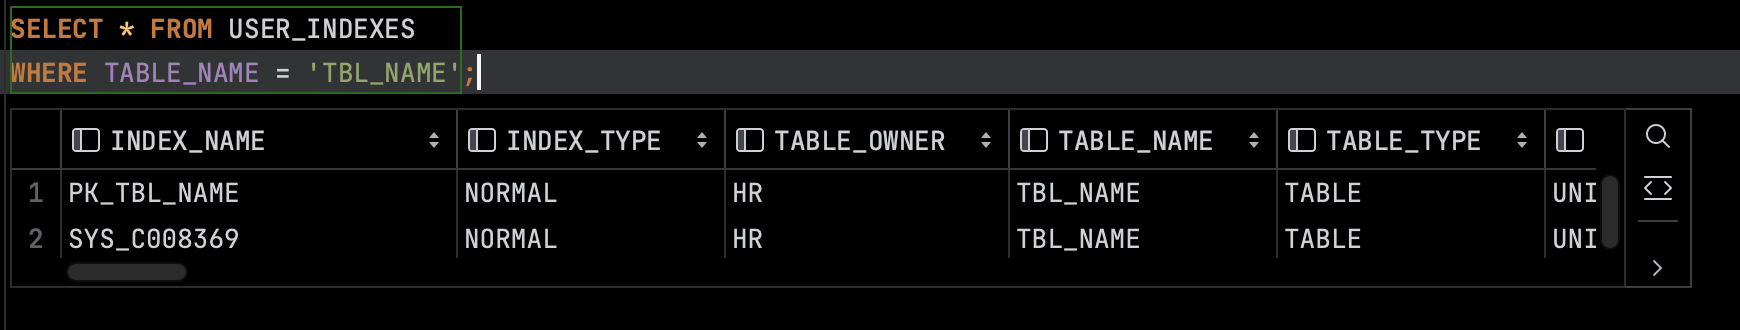
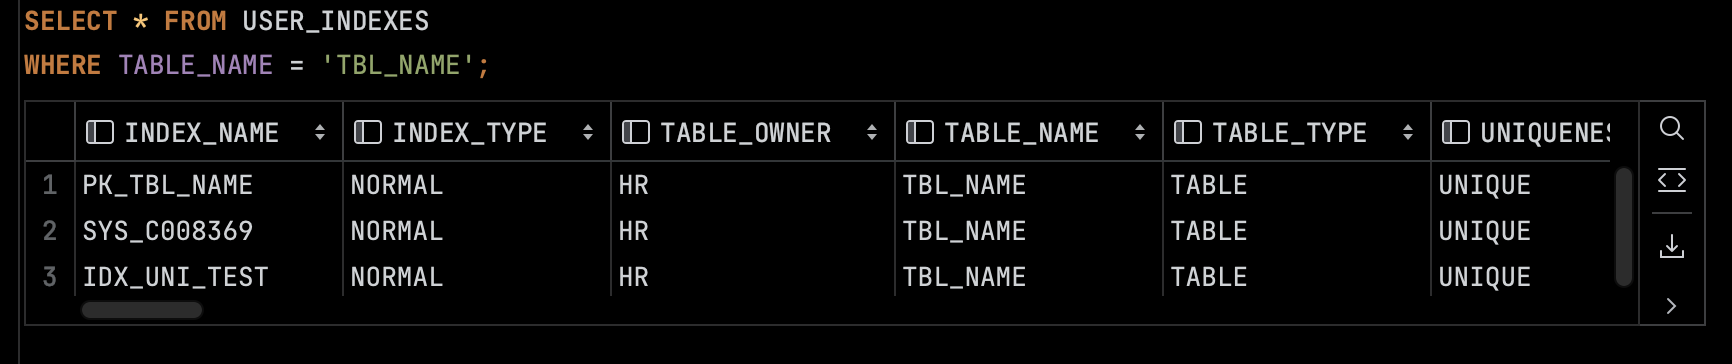
인덱스 자동 생성
CREATE TABLE tbl_name (
    key1 VARCHAR2(10),
    key2 VARCHAR2(20),
    col1 NUMBER UNIQUE,
    col2 VARCHAR2(100),
    CONSTRAINT pk_tbl_name PRIMARY KEY (key1, key2)
);
인덱스 수동 생성
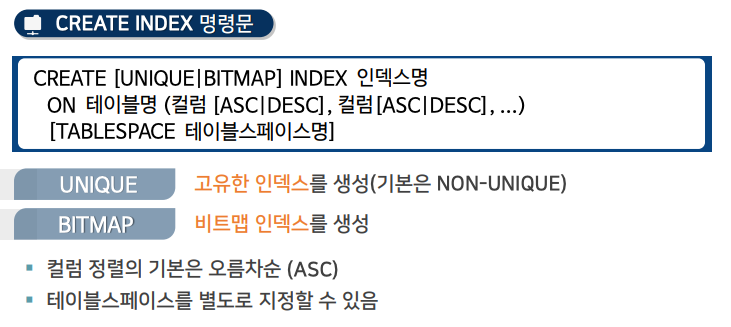
CREATE UNIQUE INDEX idx_uni_test on tbl_name(col2);
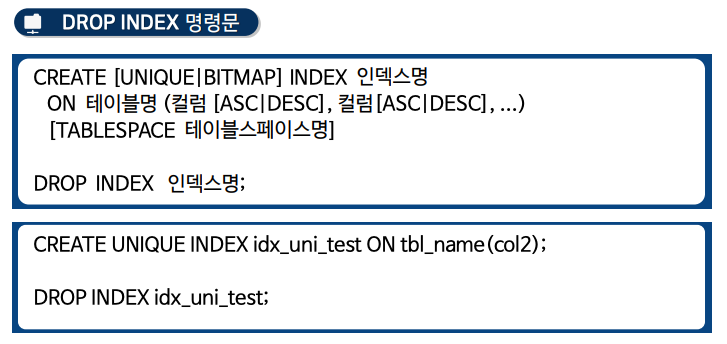
인덱스 삭제
인덱스 관리
인덱스 분석
- 입력, 수정 발생하면서 인덱스의 균형이 흐트러짐
- 주기적으로 인덱스를 분석하고 인덱스를 재구성 해야 함
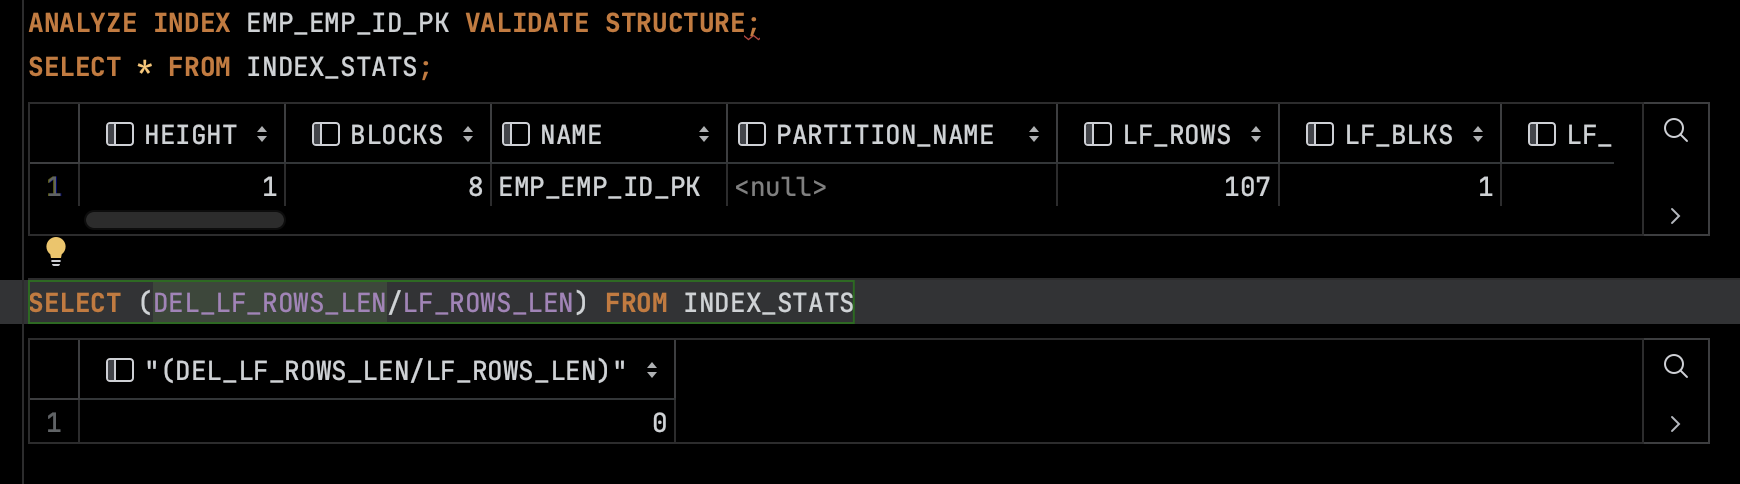
- 다음 명령은 INDEX_STATS 자료 사전(테아블)애 안덱스의 분석결과를 저장 (Oracle 21-C)
ANALYZE INDEX 인덱스명 VALIDATE STRUCTURE;
SELECT * FROM INDEX_STATS;
인덱스 밸런스 계산
- 인덱스가 한쪽으로 치우친 정보를 숫자로 보여줌
- 0이 가장 좋은 상태이며, (일반적으로) 20이 넘을 경우 인덱스를 재구성
인덱스 재구성
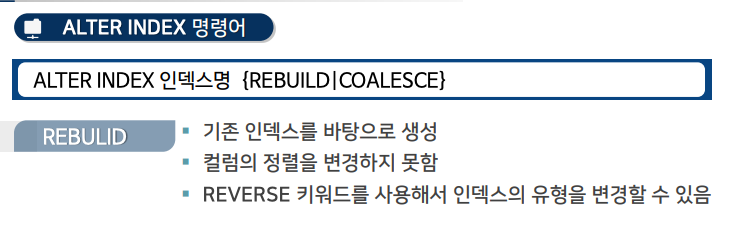
- REBUILD 옵션: 인덱스 전체를 재구성
- COALESCE 온샨: 최하위 리프 블록만 재구성
ALTER INDEX EMP_EMP_ID_PK REBUILD;
ALTER INDEX EMP_EMP_ID_PK COALESCE;